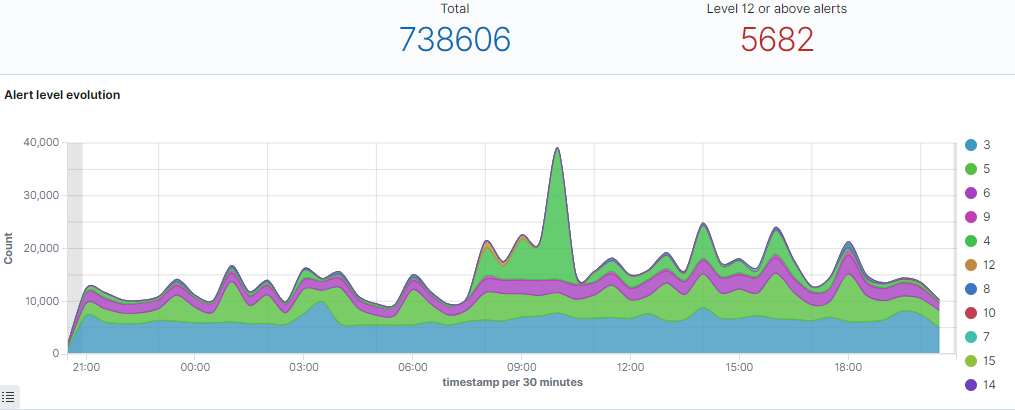
Ein Upgrade eines Wazuh-Clusters ist nicht nur eine Frage der korrekten Aktualisierung von Manager-, Worker- und Indexer-Komponenten. Gerade in größeren Umgebungen entsteht eine zusätzliche Herausforderung, sobald nach einem Wartungsfenster mehrere Tausend Wazuh-Agenten nahezu gleichzeitig ihre Verbindung zum Cluster wiederherstellen.
Die Folge können kurzfristige Lastspitzen, überfüllte Decoder-Queues und im ungünstigsten Fall verlorene Security-Events sein.
Besonders kritisch ist dieses Verhalten in SIEM-Umgebungen, in denen die kontinuierliche Verarbeitung sicherheitsrelevanter Ereignisse eine zentrale Rolle spielt. Ein erfolgreich abgeschlossenes Cluster-Upgrade bedeutet schließlich noch nicht, dass auch sämtliche während der Wartung zwischengespeicherten Ereignisse vollständig verarbeitet wurden.
Dieser Artikel zeigt, wie sich solche Lastspitzen mithilfe von HAProxy reduzieren lassen, welche Möglichkeiten Wazuh selbst bietet und wie Warnmeldungen nach einem Cluster-Upgrade richtig einzuordnen sind.
1. Ausgangslage / Problemstellung
In einer Wazuh-Cluster-Umgebung mit mehreren Worker-Nodes werden eingehende Agent-Verbindungen über einen HAProxy-Load-Balancer verteilt.
Die Architektur sieht vereinfacht folgendermaßen aus:
Wazuh-Agenten
Mehrere Hundert bis Tausende Endpoints
TCP/1514
HAProxy Load Balancer
Verteilung und Begrenzung neuer Verbindungen
Worker 1
analysisd
Worker 2
analysisd
Worker 3
analysisd
Wazuh Indexer
Persistierung und Suche
Während eines vollständigen Cluster-Upgrades wird der eingehende Agent-Traffic am Load Balancer vorübergehend gestoppt. Die Agenten verlieren dadurch ihre Verbindung zu den Wazuh-Managern.
Abhängig von ihrer Konfiguration puffern die Agenten weiterhin Ereignisse lokal.
Sobald der Load Balancer wieder aktiviert wird, versuchen viele Agenten innerhalb kurzer Zeit, sich erneut zu verbinden und ihre aufgelaufenen Daten zu übertragen.
Dabei treten mehrere Belastungen gleichzeitig auf:
- Zahlreiche neue TCP-Verbindungen müssen aufgebaut und authentifiziert werden.
- Lokal gepufferte Ereignisse werden an die Worker übertragen.
- Wazuh-Manager müssen eingehende Events dekodieren und analysieren.
- Module wie Syscollector, FIM und SCA können zusätzliche Daten erzeugen.
- Synchronisations- und Indexierungsprozesse beanspruchen weitere Ressourcen.
In der untersuchten Umgebung führte diese Situation zu kurzfristigen Überlastungen des Dienstes wazuh-analysisd und Warnmeldungen über vollständig ausgelastete Queues.
Die Herausforderung bestand darin, den Wiederanlauf des Clusters zu entzerren, ohne dauerhaft die Anzahl der verbundenen Agenten einzuschränken.
2. Technische Analyse
2.1 Warum gleichzeitige Agent-Reconnects problematisch sind
Wazuh-Agenten besitzen Mechanismen zur Zwischenspeicherung und kontrollierten Übertragung von Ereignissen. Diese verhindern jedoch nicht automatisch eine Lastspitze, wenn sich sehr viele Agenten gleichzeitig wieder mit dem Cluster verbinden.
Dabei müssen zwei unterschiedliche Belastungsarten betrachtet werden.
Verbindungsaufbau: Jeder Agent benötigt eine TCP-Verbindung zu einem Wazuh-Manager. Bei Tausenden gleichzeitigen Verbindungsversuchen entstehen zusätzliche Anforderungen an Netzwerk, Betriebssystem und Manager-Dienste.
Ereignisverarbeitung: Nach erfolgreichem Verbindungsaufbau können Agenten ihre zwischengespeicherten Ereignisse übertragen. Die dabei entstehende Event-Rate kann deutlich über der normalen Betriebsbelastung liegen.
Entscheidend ist daher nicht nur die Anzahl gleichzeitig verbundener Agenten, sondern auch die Geschwindigkeit, mit der Ereignisse in die Verarbeitungspipeline gelangen.
2.2 Die Rolle von wazuh-analysisd
Der Dienst wazuh-analysisd ist eine zentrale Komponente der Wazuh-Manager-Architektur.
Er verarbeitet eingehende Ereignisse unter anderem durch:
- Dekodierung der Event-Daten
- Anwendung von Wazuh-Regeln
- Korrelation sicherheitsrelevanter Informationen
- Generierung von Alerts
- Verarbeitung bestimmter interner Synchronisationsnachrichten
Für diese Verarbeitung verwendet Wazuh verschiedene interne Queues.
Wenn Ereignisse schneller eintreffen, als sie verarbeitet werden können, steigt die Queue-Auslastung.
Im beschriebenen Szenario erschien folgende Warnmeldung:
wazuh-analysisd: WARNING:
Database synchronization decoder queue is full.
Diese Meldung zeigt an, dass die Decoder-Queue für Datenbanksynchronisationsnachrichten ihre Kapazitätsgrenze erreicht hat.
Wichtig: Eine solche Warnung ist nicht gleichbedeutend mit einem vollständigen Ausfall des Wazuh-Managers. Sie ist jedoch ein Hinweis auf eine Überlastung, bei der Nachrichten verloren gehen können.
Auch wenn sich das System nach einigen Minuten stabilisiert, sollte diese Meldung nicht grundsätzlich als unkritisch eingestuft werden.
Insbesondere nach Wartungsfenstern muss geprüft werden, ob lediglich eine vorübergehende Queue-Sättigung vorlag oder tatsächlich Daten beziehungsweise Synchronisationsinformationen verloren gegangen sind.
2.3 Warum Syscollector und andere Module zusätzliche Last erzeugen können
Neben der normalen Event-Übertragung können Wazuh-Module zusätzliche Informationen an den Manager senden.
Dazu gehören beispielsweise:
| Modul | Typische Daten |
|---|---|
| Syscollector | Betriebssystem, Softwarepakete, Netzwerk, Hardware |
| FIM / Syscheck | Dateiänderungen und Integritätsinformationen |
| SCA | Ergebnisse von Security-Configuration-Assessments |
| Logcollector | System- und Anwendungsevents |
Besonders umfangreiche Inventarisierungs- oder Compliance-Scans können die Last nach einem Wartungsfenster zusätzlich erhöhen.
Allerdings ist ein Reconnect nicht automatisch mit einem vollständigen Neustart aller Module gleichzusetzen.
Ein Agent, der lediglich seine Verbindung zum Manager verliert und anschließend wiederherstellt, startet nicht zwangsläufig einen neuen Syscollector-Scan.
Das ist bei der Wahl geeigneter Gegenmaßnahmen wichtig.
2.4 Wazuh bietet keine direkte Begrenzung der Reconnect-Rate
In der betrachteten Wazuh-Version 4.14.9-1 existiert keine dedizierte Manager-Einstellung, mit der sich beispielsweise festlegen lässt:
Allow only 10 new agent connections per secondDie Begrenzung des Verbindungsaufbaus muss deshalb außerhalb des Wazuh-Managers erfolgen.
Ein Load Balancer wie HAProxy ist hierfür ein geeigneter Ansatz, weil er bereits vor dem eigentlichen Wazuh-Cluster über die Annahme neuer Verbindungen entscheiden kann.
Dabei ist zwischen einer Rate-Begrenzung und einer Begrenzung gleichzeitig aktiver Verbindungen zu unterscheiden.
Eine Rate-Begrenzung kontrolliert, wie viele neue Sessions innerhalb eines Zeitraums zugelassen werden.
Eine Begrenzung aktiver Sessions definiert dagegen, wie viele Verbindungen gleichzeitig bestehen dürfen.
Für das Reconnect-Problem ist vor allem die Rate neuer Sessions relevant.
3. Lösung / Best Practices
3.1 HAProxy: Neue Sessions gezielt begrenzen
Die praktisch erprobte Lösung bestand darin, den HAProxy-Frontend für den Wazuh-Agent-Traffic um eine Session-Rate-Begrenzung zu ergänzen.
Die Konfiguration sah folgendermaßen aus:
frontend wazuh_reporting_front
    mode tcp
    bind :1514 name wazuh_reporting_front_bind
    default_backend wazuh_reporting
    rate-limit sessions 20
Der entscheidende Parameter ist:
rate-limit sessions 20Damit begrenzt HAProxy die Annahmerate neuer Sessions am Frontend auf ungefähr 20 Sessions pro Sekunde.
Neue Verbindungsversuche oberhalb des Limits werden nicht einfach beliebig lange in einer Warteschlange gehalten. Sie können abgewiesen werden und müssen gegebenenfalls durch die Reconnect-Mechanismen der Clients erneut versucht werden.
Die Einstellung garantiert daher keine gleichmäßige, verlustfreie Abarbeitung aller Verbindungsversuche. Sie kann aber den unmittelbaren Ansturm auf die Wazuh-Worker deutlich reduzieren.
Wirkung der Begrenzung
Eine theoretische Betrachtung verdeutlicht den Effekt.
Bei 6.000 Agenten und einer Rate von 20 neuen Sessions pro Sekunde ergibt sich:
\[ \frac{6000}{20}=300\text{ Sekunden} \]
Das entspricht einer idealisierten Mindestdauer von fünf Minuten, bis alle 6.000 Agenten jeweils eine Verbindung aufgebaut haben.
Theoretische Verbindungsdauer berechnenWazuh-Agenten
6.000Neue Sessions pro Sekunde
20
Idealisierte Mindestdauer
5 Min. 00 Sek.
Ohne erneute Verbindungsversuche, andere Sessions oder zusätzliche Verzögerungen
In der Praxis können Wiederholungsversuche, Timeouts, Verbindungsverteilung und die Reconnect-Intervalle der Agenten die tatsächliche Dauer verlängern.
Die Rate sollte deshalb nicht blind übernommen, sondern anhand der vorhandenen Cluster-Kapazität bestimmt werden.
Konfiguration prüfen
Nach der Anpassung sollte zunächst die HAProxy-Konfiguration validiert werden:
haproxy -c -f /etc/haproxy/haproxy.cfgAnschließend kann die Konfiguration über den jeweiligen HAProxy-Service beziehungsweise die eingesetzte Managementlösung übernommen werden.
Bei HAProxy-Installationen, die durch zusätzliche Konfigurationswerkzeuge verwaltet werden, muss sichergestellt werden, dass die Einstellung bei einer erneuten Konfigurationsgenerierung erhalten bleibt.
Ergebnis im praktischen Betrieb
Bei einem Upgrade auf Wazuh 4.14.9-1 wurde eine Begrenzung auf 20 Sessions pro Sekunde eingesetzt.
Dadurch verzögerte sich der Reconnect-Prozess zwar etwas, der Cluster überstand den Wiederanlauf jedoch ohne die zuvor beobachteten gravierenden Probleme.
Das zeigt, dass bereits eine vergleichsweise einfache Rate-Begrenzung am Load Balancer eine wirksame Maßnahme gegen Reconnect-Spitzen sein kann.
Allerdings ist eine erfolgreich wiederhergestellte Agent-Verbindung noch kein Nachweis dafür, dass sämtliche gepufferten Ereignisse verarbeitet wurden.
3.2 Agent-seitige Event-Rate über client_buffer begrenzen
Eine zweite Möglichkeit besteht darin, die Übertragungsrate der Agenten bereits vor der Wartung zu reduzieren.
Wazuh unterstützt dafür die Konfiguration:
<client_buffer>
  <disabled>no</disabled>
  <queue_size>5000</queue_size>
  <events_per_second>100</events_per_second>
</client_buffer>
Der Parameter:
<events_per_second>100</events_per_second>begrenzt die Event-Übertragungsrate des jeweiligen Agenten im Rahmen seines Agent-Buffers.
Die Einstellung wirkt pro Agent, nicht als globale Grenze für den gesamten Cluster.
Wenn beispielsweise 1.000 Agenten jeweils bis zu 100 Events pro Sekunde übertragen können, ergibt sich rechnerisch weiterhin ein mögliches Gesamtvolumen von 100.000 Events pro Sekunde.
Deshalb muss die Einstellung zur tatsächlichen Kapazität der Worker passen.
Empfohlene Vorgehensweise:
- Vor dem Wartungsfenster die gewünschte Event-Rate festlegen.
- Die Agent-Buffer-Konfiguration zentral verteilen, soweit die eingesetzte Wazuh-Version und Konfigurationsmethode dies unterstützen.
- Überprüfen, ob die Agenten die Konfiguration übernommen haben.
- Erst danach die Wartungsarbeiten beginnen.
- Nach Wiederherstellung des Clusters die Verarbeitungslast überwachen.
- Nach dem Abbau des Event-Rückstaus die ursprünglichen Einstellungen wiederherstellen.
Eine wichtige Einschränkung besteht darin, dass eine niedrigere Event-Rate den lokalen Buffer stärker beanspruchen kann.
Wenn dauerhaft mehr Ereignisse erzeugt als übertragen werden, drohen auch auf Agent-Seite Queue-Überläufe.
Die Rate-Begrenzung sollte daher nur zusammen mit einer geeigneten Buffer-Konfiguration und ausreichender Speicherkapazität eingesetzt werden.
Außerdem müssen die Konfigurationsmöglichkeiten der jeweiligen Agent-Version geprüft werden.
3.3 Syscollector-Scans vor dem Upgrade entzerren
Eine weitere Überlegung besteht darin, umfangreiche Inventarisierungsscans vorübergehend zu reduzieren.
Dafür kann die zentral verteilte Agent-Konfiguration angepasst werden.
Ein mögliches Beispiel:
<agent_config>
  <wodle name="syscollector">
    <disabled>no</disabled>
    <interval>12h</interval>
    <scan_on_start>no</scan_on_start>
    <hardware>yes</hardware>
    <os>yes</os>
    <network>yes</network>
    <packages>yes</packages>
    <ports all="no">no</ports>
    <processes>no</processes>
  </wodle>
</agent_config>
Die Datei befindet sich typischerweise unter:
/var/ossec/etc/shared/default/agent.confDer Pfad bezieht sich auf die zentralisierte Agent-Konfiguration der Gruppe default.
Bei anderen Agent-Gruppen muss die entsprechende gruppenspezifische Datei verwendet werden.
Die wichtigsten Einstellungen sind:
| Parameter | Bedeutung |
|---|---|
interval | Zeitlicher Abstand zwischen Syscollector-Scans |
scan_on_start | Legt fest, ob beim Modulstart ein Scan erfolgt |
packages | Erfasst installierte Softwarepakete |
network | Erfasst Netzwerkinformationen |
hardware | Erfasst Hardwareinformationen |
Mit:
<interval>12h</interval>
<scan_on_start>no</scan_on_start>
wird ein längeres Scanintervall definiert und ein zusätzlicher Scan beim Modulstart verhindert.
Allerdings ist hier eine wichtige Unterscheidung notwendig:
Ein reiner Agent-Reconnect löst nicht automatisch einen neuen Syscollector-Scan aus.
Die Änderung von scan_on_start verhindert deshalb nicht unmittelbar, dass Agenten ihre zuvor gepufferten Ereignisse übertragen.
Sie kann aber sinnvoll sein, wenn im Wartungsfenster auch Agenten oder Module neu gestartet werden oder wenn eine neue zentralisierte Konfiguration Modulneustarts auslöst.
Ähnliche Überlegungen gelten für FIM- und SCA-Scans.
Die temporäre Verlängerung von Scanintervallen kann die Gesamtlast reduzieren, sollte aber nicht unkontrolliert erfolgen.
Längere Scanintervalle bedeuten schließlich auch, dass neue Schwachstelleninformationen, Konfigurationsabweichungen oder Dateiänderungen möglicherweise später erkannt werden.
3.4 Wazuh-Cluster möglichst schrittweise aktualisieren
Eine weitere Möglichkeit zur Reduzierung der Reconnect-Last besteht darin, nicht alle Manager-Nodes gleichzeitig außer Betrieb zu nehmen.
Soweit die jeweilige Wazuh-Upgrade-Prozedur dies unterstützt, kann ein schrittweises Vorgehen sinnvoll sein.
Dabei werden Worker kontrolliert aus dem Load Balancer genommen, aktualisiert, geprüft und anschließend wieder in Betrieb genommen.
So bleiben andere Worker während des Wartungsfensters erreichbar.
Allerdings muss die offizielle Upgrade-Reihenfolge berücksichtigt werden. Insbesondere Versionskompatibilität, Cluster-Synchronisation und die Reihenfolge der Manager- und Indexer-Aktualisierung dürfen nicht zugunsten eines vermeintlich unterbrechungsfreien Upgrades ignoriert werden.
Ein Rolling Upgrade ist daher nur dann geeignet, wenn es für den konkreten Versionswechsel unterstützt wird.
4. Warnmeldungen nach dem Upgrade richtig interpretieren
Nach dem erfolgreichen Wiederanlauf des Clusters können weitere Warnmeldungen auftreten.
Diese müssen differenziert betrachtet werden.
4.1 Indexer-Connector: Local mirror holds no entry
Ein Beispiel:
indexer-connector: WARNING:
Local mirror holds no entry for agent '1489':
deleting the 40 document(s) the index
reports for it.

Expected when the agent has just moved
to this node; otherwise the mirror was lost.
Diese Meldung entsteht im Zusammenhang mit dem lokalen Zustand, den der Indexer-Connector über Agent-Daten verwaltet.
Wenn ein Agent nach einem Reconnect auf einem anderen Worker landet, kann der lokale Mirror dieses Workers von den im Indexer vorhandenen Dokumenten abweichen.
Der Connector erkennt diese Abweichung und führt eine Bereinigung beziehungsweise Synchronisierung durch.
Bei einem kürzlich auf einen anderen Worker gewechselten Agenten kann dieses Verhalten erwartbar sein.
Allerdings enthält die Meldung selbst bereits einen wichtigen Hinweis:
otherwise the mirror was lostWenn die Warnung ohne nachvollziehbaren Agent-Wechsel oder dauerhaft auftritt, sollte untersucht werden, ob ein Problem mit dem lokalen Mirror oder der Synchronisation besteht.
Die Warnung ist daher nicht grundsätzlich harmlos.
Empfehlung: Nach dem Upgrade prüfen, ob die Meldungen mit zunehmender Stabilisierung der Agent-Verbindungen zurückgehen und ob die betroffenen Agenten anschließend konsistente Inventar- und Statusinformationen besitzen.
4.2 Database synchronization decoder queue is full
Die zweite relevante Warnung lautet:
wazuh-analysisd: WARNING:
Database synchronization decoder queue is full.
Diese Meldung steht unmittelbar mit der Überlastung der Datenbanksynchronisations-Decoder-Queue in Zusammenhang.
Während des Reconnect-Vorgangs können sehr viele Synchronisationsinformationen gleichzeitig eintreffen.
Wird die Queue vollständig ausgelastet, können Nachrichten verworfen werden.
Dass eine solche Meldung unmittelbar nach einem umfangreichen Reconnect auftritt, ist technisch nachvollziehbar.
Trotzdem sollte sie nicht einfach ignoriert werden.
Die entscheidende Frage ist, ob es sich um eine kurzzeitige Lastspitze handelt oder ob der Cluster dauerhaft mehr Daten erhält, als er verarbeiten kann.
Ein einmaliger Warnhinweis nach einem vollständigen Cluster-Neustart ist anders zu bewerten als dauerhaft auftretende Queue-Überläufe im Normalbetrieb.
4.3 Welche Kontrollen sind nach dem Upgrade sinnvoll?
Nach der Wiederherstellung der Agent-Verbindungen sollten insbesondere folgende Punkte überprüft werden:
- Agent-Status: Sind alle erwarteten Agenten wieder verbunden?
- Event-Durchsatz: Erreicht die Event-Verarbeitung wieder das übliche Niveau?
- Queue-Auslastung: Treten weiterhin Überläufe oder Drops auf?
- Indexer-Zustand: Werden neue Alerts und Inventardaten korrekt indexiert?
- Worker-Verteilung: Sind die Agenten angemessen über die Worker verteilt?
- Logmeldungen: Gehen die Warnungen nach der Reconnect-Phase zurück?
Für die Untersuchung der Manager-Logs kann beispielsweise folgender Befehl verwendet werden:
grep -Ei \
"queue is full|events.*dropped|mirror" \
/var/ossec/logs/ossec.log
Auch die interne Wazuh-Statistik kann hilfreich sein. Sofern die entsprechenden Statistiken aktiviert sind, lassen sich unter anderem Informationen zur Auslastung und Verarbeitungsgeschwindigkeit auswerten.
Wichtig ist außerdem, einen möglichen Datenverlust nicht allein anhand der Anzahl vorhandener Alerts zu bewerten.
Nicht jedes eingehende Event erzeugt einen Alert.
Für eine belastbare Prüfung müssen daher die jeweils relevanten Event-, Queue- und Indexierungsmetriken betrachtet werden.
5. Lessons Learned / Best Practices
Aus dem beschriebenen Szenario lassen sich mehrere Empfehlungen für den Betrieb größerer Wazuh-Cluster ableiten.
Reconnect-Rate und Event-Rate getrennt behandeln
Eine HAProxy-Rate-Begrenzung reduziert die Geschwindigkeit neuer Verbindungsaufbauten.
Sie begrenzt jedoch nicht automatisch die Anzahl der Events, die bereits verbundene Agenten übertragen.
Deshalb können auch bei einer begrenzten Session-Rate weiterhin Lastspitzen entstehen.
Die Kombination aus HAProxy-Session-Limit und angepasstem Agent-Buffer kann sinnvoll sein, wenn der Cluster besonders empfindlich auf plötzliche Event-Spitzen reagiert.
Grenzwerte anhand realer Lastdaten bestimmen
Ein Wert von 20 Sessions pro Sekunde kann in einer Umgebung gut funktionieren, während er in einer anderen Umgebung unnötig restriktiv oder immer noch zu hoch ist.
Entscheidend sind unter anderem die Anzahl der Agenten, das normale Event-Volumen, die durchschnittliche Dauer des Wartungsfensters, die vorhandene CPU- und Speicherkapazität sowie die Anzahl der Worker-Nodes.
Ein sinnvoller Grenzwert sollte deshalb anhand von Messungen bestimmt werden.
Monitoring bereits vor dem Wartungsfenster vorbereiten
Queue-Auslastung, Event-Durchsatz und Agent-Verbindungsstatus sollten schon vor dem Upgrade beobachtet werden.
Nur so lässt sich später beurteilen, ob die Last nach dem Reconnect wieder auf das normale Niveau zurückgekehrt ist.
Idealerweise werden die Werte während des gesamten Wartungsfensters aufgezeichnet.
Konfigurationsänderungen rechtzeitig verteilen
Eine zentralisierte Agent-Konfiguration ist nur dann wirksam, wenn sie vor der Unterbrechung von den betroffenen Agenten übernommen wurde.
Temporäre Anpassungen unmittelbar vor dem Abschalten des Load Balancers können deshalb zu spät kommen.
Sicherheit und Performance gemeinsam betrachten
Eine Reduzierung der Event-Rate oder eine Verlängerung von Scanintervallen kann die Stabilität verbessern.
Gleichzeitig kann dadurch die Erkennung sicherheitsrelevanter Ereignisse verzögert werden.
Deshalb sollten solche Maßnahmen zeitlich begrenzt und dokumentiert sein.
Insbesondere in Umgebungen mit hohen Compliance-Anforderungen muss klar sein, welche Auswirkungen das Wartungsfenster auf die Sichtbarkeit von Security-Events hat.
Empfohlener Ablauf für ein kontrolliertes Upgrade
- VorbereitungNormalen Event-Durchsatz erfassen, Agent-Zahlen prüfen, Queue-Metriken beobachten und Backups erstellen.
- Temporäre KonfigurationBei Bedarf Agent-Buffer und Scanintervalle anpassen, rechtzeitig verteilen und die Übernahme überprüfen.
- Upgrade durchführenDen offiziellen Upgrade-Pfad einhalten und Worker möglichst schrittweise warten, sofern unterstützt.
- Reconnect kontrollierenHAProxy mit einer getesteten Session-Rate aktivieren und den Verbindungsaufbau überwachen.
- Cluster stabilisierenQueue-Auslastung, Synchronisation, Event-Verarbeitung und Indexer-Zustand prüfen.
- Normalbetrieb wiederherstellenTemporäre Limits zurücknehmen, Backlogs prüfen und den Abschluss der Wartung dokumentieren.
6. Fazit
Ein Wazuh-Cluster-Upgrade kann technisch erfolgreich abgeschlossen sein und trotzdem zu Problemen bei der anschließenden Ereignisverarbeitung führen.
Besonders bei großen Agent-Installationen stellt der gleichzeitige Reconnect vieler Endpoints eine erhebliche Belastung für die Worker-Nodes dar.
Die Begrenzung neuer TCP-Sessions über HAProxy ist eine vergleichsweise einfache Möglichkeit, den Wiederanlauf kontrollierter zu gestalten.
Die Konfiguration
rate-limit sessions 20hat sich in einem praktischen Upgrade-Szenario mit Wazuh 4.14.9-1 als hilfreich erwiesen.
Sie sollte jedoch nicht als universelle Lösung betrachtet werden. Für eine robuste Strategie müssen zusätzlich Agent-Buffer, Event-Durchsatz, Queue-Kapazitäten und die eingesetzten Wazuh-Module berücksichtigt werden.
Warnmeldungen wie Database synchronization decoder queue is full sind nach einem umfangreichen Reconnect zwar erklärbar, weisen aber auf reale Kapazitätsgrenzen hin und können mit Nachrichtenverlusten verbunden sein.
Das wichtigste Ziel eines Wartungsfensters sollte deshalb nicht nur sein, alle Agenten wieder online zu bringen, sondern auch sicherzustellen, dass die aufgelaufenen sicherheitsrelevanten Daten zuverlässig verarbeitet werden.
Weiterführende Dokumentation
- HAProxy Configuration Manual – Konfigurationsreferenz für Frontends, Session-Limits und Traffic-Steuerung.
- Wazuh – Anti-flooding mechanism – Agent-Buffer und Begrenzung der Event-Übertragungsrate.
- Wazuh – Centralized configuration – Verwaltung zentraler Agent-Konfigurationen.
- Wazuh – System inventory configuration – Syscollector-Konfiguration und Scanintervalle.
- Wazuh – Upgrade guide – Offizielle Upgrade-Verfahren und Versionshinweise.
Hinweis: Die dokumentierten Beobachtungen beziehen sich auf Wazuh 4.14.9-1. Bei anderen Versionen sollten Konfigurationsparameter und Upgrade-Verfahren anhand der jeweiligen Versionsdokumentation überprüft werden.
Mehr zum Wazuh Ambassador Program …
https://wazuh.slack.com/archives/C0A933R8E/p1792057008813809